Che cosa succede nel secondo tra la domanda e la risposta
Quando chiedi «che cosa ho davanti?», il telefono che tieni in mano mette in moto tutta la macchina: dalla foto e dalla misurazione della profondità, passando per i modelli di IA, fino alla voce e alla vibrazione. Scorri per vedere ogni passaggio.
01Primo passaggio
Foto e profondità
La fotocamera cattura un fotogramma mentre il sensore LiDAR misura la distanza da tutto ciò che rientra nell'inquadratura. Quando il telefono non ha il LiDAR, è un modello di apprendimento automatico a stimare la profondità.
LiDAR
Mappa di profondità
Modello ML (alternativa)
02Secondo passaggio
Analisi sul dispositivo
Prima che qualcosa esca dal telefono, due modelli analizzano lo stesso fotogramma: uno riconosce se sei all'aperto o dentro un edificio, l'altro determina, a partire da punti caratteristici, se la scena è cambiata rispetto al fotogramma precedente. Se non è cambiata, non c'è motivo di inviare nulla.
Modelli ML
Punti caratteristici
Sul dispositivo
03Terzo passaggio
Invio sicuro all'IA
Il fotogramma e il contesto della conversazione arrivano al modello GPT Realtime di OpenAI nel cloud. La mappa di profondità resta sul telefono e la vibrazione viene calcolata da essa in locale. App Attest conferma che a collegarsi è davvero l'app autentica e tutto il traffico è cifrato. Questo lavoro si misura in token, ed è da lì che nasce il prezzo. I dati vengono inviati in forma anonima e nessuna persona ha accesso a ciò che vede la fotocamera.
GPT Realtime
App Attest
Cifratura
Token
04Quarto passaggio
Voce e vibrazione
Palo, a destra, molto vicino.
La risposta torna sotto forma di voce: breve e prevedibile, che cosa è, da che lato, a che distanza. Vicino a un ostacolo il telefono vibra anche, e questa funzione va perfino senza internet.
Sintesi vocale
Feedback aptico
VoiceOver
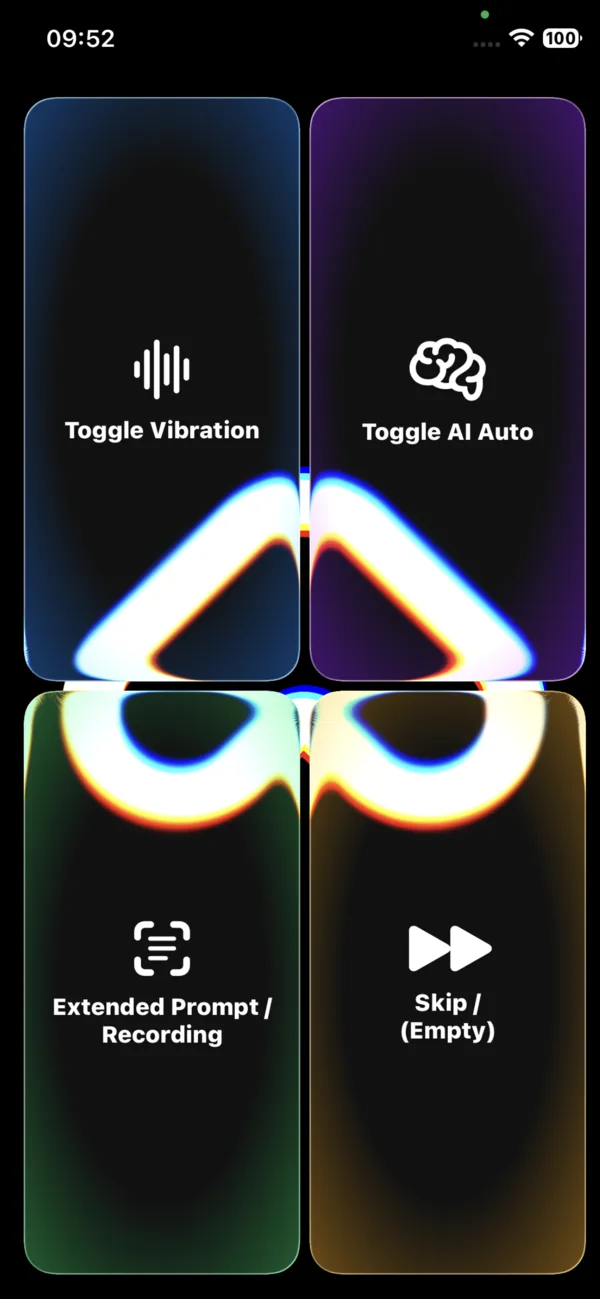
Guarda come appare sullo schermo
Tutta questa macchina sta sotto un unico schermo con quattro pulsanti. La guida ti mostra ognuno di essi.