Lo que ocurre en el segundo que va de la pregunta a la respuesta
Cuando preguntas «¿qué tengo delante?», el teléfono que llevas en la mano pone en marcha toda la maquinaria: desde la foto y la medición de la profundidad, pasando por los modelos de IA, hasta la voz y la vibración. Desplázate para ver cada paso.
01Primer paso
Foto y profundidad
La cámara captura un fotograma mientras el sensor LiDAR mide la distancia a todo lo que hay en el encuadre. Cuando el teléfono no tiene LiDAR, es un modelo de aprendizaje automático el que estima la profundidad.
LiDAR
Mapa de profundidad
Modelo ML (alternativa)
02Segundo paso
Análisis en el propio dispositivo
Antes de que nada salga del teléfono, dos modelos analizan el mismo fotograma: uno reconoce si estás en la calle o dentro de un edificio; el otro, a partir de puntos característicos, determina si la escena ha cambiado desde el fotograma anterior. Si no ha cambiado, no hay motivo para enviar nada.
Modelos ML
Puntos característicos
En el dispositivo
03Tercer paso
Envío seguro a la IA
El fotograma y el contexto de la conversación viajan al modelo GPT Realtime de OpenAI en la nube. El mapa de profundidad se queda en el teléfono y la vibración se calcula a partir de él de forma local. App Attest confirma que quien se conecta es la aplicación auténtica y todo el tráfico va cifrado. Este trabajo se mide en tokens, y de ahí sale el precio. Los datos se envían de forma anónima y ninguna persona tiene acceso a lo que ve la cámara.
GPT Realtime
App Attest
Cifrado
Tokens
04Cuarto paso
Voz y vibración
Poste, a la derecha, muy cerca.
La respuesta vuelve en voz: breve y predecible, qué es, por qué lado y a qué distancia. Junto a un obstáculo el teléfono además vibra, y esa función funciona incluso sin internet.
Síntesis de voz
Respuesta háptica
VoiceOver
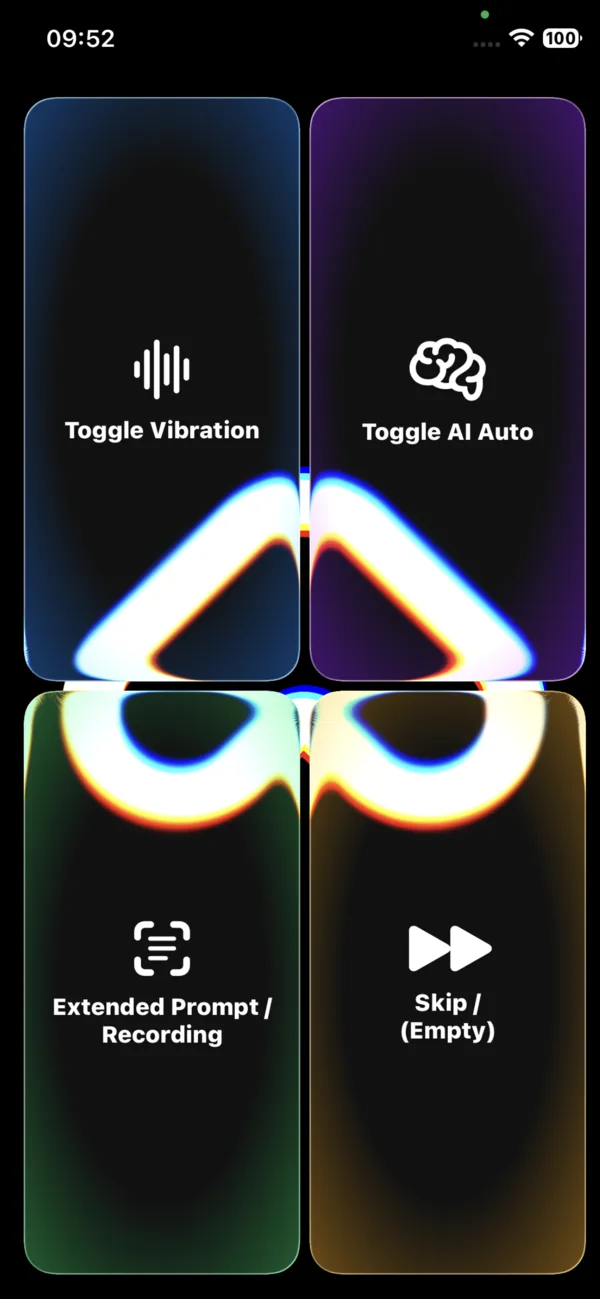
Mira cómo se ve en la pantalla
Toda esta maquinaria cabe debajo de una sola pantalla con cuatro botones. La guía te muestra cada uno de ellos.