Ce qui se passe dans la seconde entre la question et la réponse
Quand tu demandes « qu'est-ce qu'il y a devant moi ? », le téléphone que tu tiens en main met toute la mécanique en marche : de la photo et de la mesure de profondeur, en passant par les modèles d'IA, jusqu'à la voix et à la vibration. Fais défiler pour voir chaque étape.
01Première étape
Photo et profondeur
L'appareil photo capture une image pendant que le capteur LiDAR mesure la distance de tout ce qui se trouve dans le cadre. Quand le téléphone n'a pas de LiDAR, c'est un modèle d'apprentissage automatique qui estime la profondeur.
LiDAR
Carte de profondeur
Modèle ML (solution de repli)
02Deuxième étape
Analyse sur l'appareil
Avant que quoi que ce soit ne quitte le téléphone, deux modèles analysent la même image : l'un reconnaît si tu es dehors ou à l'intérieur, l'autre détermine, à partir de points caractéristiques, si la scène a changé depuis l'image précédente. Si rien n'a changé, inutile d'envoyer quoi que ce soit.
Modèles ML
Points caractéristiques
Sur l'appareil
03Troisième étape
Envoi sécurisé vers l'IA
L'image et le contexte de la conversation partent vers le modèle GPT Realtime d'OpenAI dans le cloud. La carte de profondeur reste sur le téléphone, et la vibration en est calculée localement. App Attest confirme que c'est bien la véritable application qui se connecte, et tout le trafic est chiffré. Ce travail se mesure en tokens, et c'est de là que vient le prix. Les données sont envoyées de façon anonyme et aucune personne n'a accès à ce que voit la caméra.
GPT Realtime
App Attest
Chiffrement
Tokens
04Quatrième étape
Voix et vibration
Poteau, à droite, très près.
La réponse revient sous forme de voix : courte et prévisible, ce que c'est, de quel côté, à quelle distance. Près d'un obstacle, le téléphone vibre en plus, et cette fonction marche même sans internet.
Synthèse vocale
Retour haptique
VoiceOver
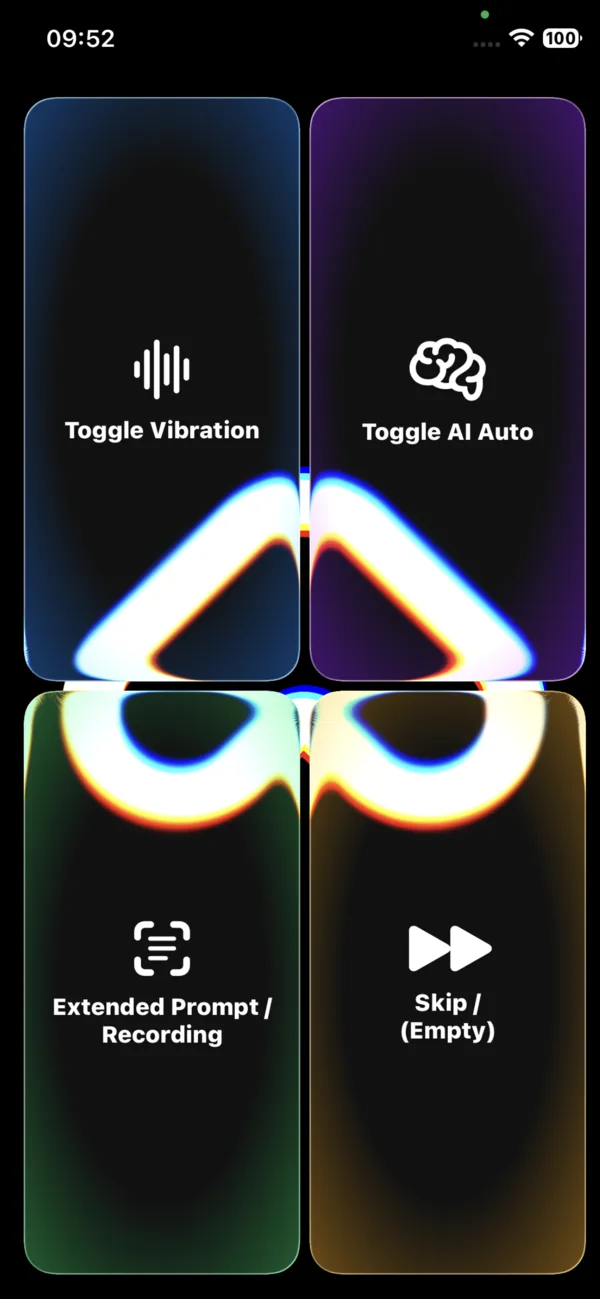
Regarde à quoi ça ressemble à l'écran
Toute cette mécanique tient sous un seul écran à quatre boutons. Le guide te présente chacun d'eux.